
DeepSeek AI es un modelo de inteligencia artificial abierto y avanzado que cumple muy bien su función incluso sin GPU. Junto con Ollama, esta tecnología permite ejecutar la IA en local, de modo que tienes el control total sobre el rendimiento y el nivel de privacidad.
Alojar DeepSeek en tu propio servidor garantiza un alto nivel de seguridad, porque desaparece el riesgo de que los datos se intercepten a través de la API. Como los servidores oficiales de DeepSeek se saturan a menudo, la instalación local te permite usar solo tus propios recursos de cálculo, sin compartirlos con nadie.
¿Qué requisitos vamos a necesitar?
Veamos una comparativa de modelos con distintos requisitos del sistema. Todos los modelos están adaptados para funcionar tanto en CPU como en GPU. Sin embargo, como la instalación se hace en un servidor, en este artículo nos centraremos sobre todo en configurar y usar el modelo con la potencia de cálculo del procesador.
| Versión del modelo | Tamaño | RAM | Plan adecuado | |
|---|---|---|---|---|
| deepseek-r1:1.5b | 1.1 GB | desde 4 GB | DE-RZ9-2 | Tareas sencillas, ideal para pruebas y primeros arranques. |
| deepseek-r1:7b | 4.7 GB | desde 8 GB | DE-RZ9-4 | Redacción y traducción de textos. Desarrollo de código sencillo. |
| deepseek-r1:8b | 5.2 GB | desde 8 GB | DE-RZ9-4 | Versión actualizada que Ollama instala por defecto si no indicas el tamaño del modelo. |
| deepseek-r1:14b | 9 GB | desde 16 GB | DE-RZ9-8 | Capacidades avanzadas en desarrollo y redacción. Un equilibrio excelente entre velocidad y funciones. |
| deepseek-r1:32b | 20 GB | desde 32 GB | DE-RZ9-16 | Según las pruebas de los desarrolladores, comparable a OpenAI o1-mini. Análisis de datos en profundidad. En el procesador responde despacio. |
| deepseek-r1:70b | 43 GB | desde 64 GB | Servidor dedicado (próximamente) | Cálculo de alto nivel para tareas de empresa. Análisis de datos profundo y desarrollo complejo. |
| deepseek-r1:671b | 404 GB | desde 512 GB | Configuración a medida (próximamente) | El modelo completo de DeepSeek R1, el más potente de la familia. Necesita un servidor dedicado potente con discos NVMe. |
Instalación paso a paso del modelo DeepSeek 14B en el servidor
Como ejemplo, instalaremos el modelo 14B, que ofrece la mejor relación entre rendimiento y consumo de recursos. Estas instrucciones sirven para cualquier modelo de la lista, así que puedes instalar otra versión si lo necesitas.
WARNING
Para la instalación usamos el plan DE-RZ9-16 (16 vCPU, 32 GB de RAM) con Ubuntu 22.04 – sus recursos sobran para el modelo 14B.
Actualiza los repositorios y paquetes del sistema:
sudo apt update && sudo apt upgrade -yInstala Ollama – el gestor para desplegar DeepSeek:
curl -fsSL https://ollama.com/install.sh | sh && sudo systemctl start ollamaDescarga el modelo de DeepSeek que hayas elegido:
ollama pull deepseek-r1:14bINFO
Ten en cuenta que puedes sustituir deepseek-r1:14b por otra versión de la tabla, por ejemplo deepseek-r1:32b. El modelo 14B pesa unos 9 GB y con un canal de 1 Gbit/s se descarga en pocos minutos.
Ejecuta el modelo de DeepSeek:
ollama run deepseek-r1:14bTras ejecutar este comando aparecerá una interfaz para escribir mensajes, y podrás empezar a conversar con la inteligencia artificial.
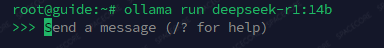
Comandos adicionales
También puedes enviar una consulta suelta:
ollama run deepseek-r1:14b "What is heavier: 1 kg of iron or 1 kg of feathers?"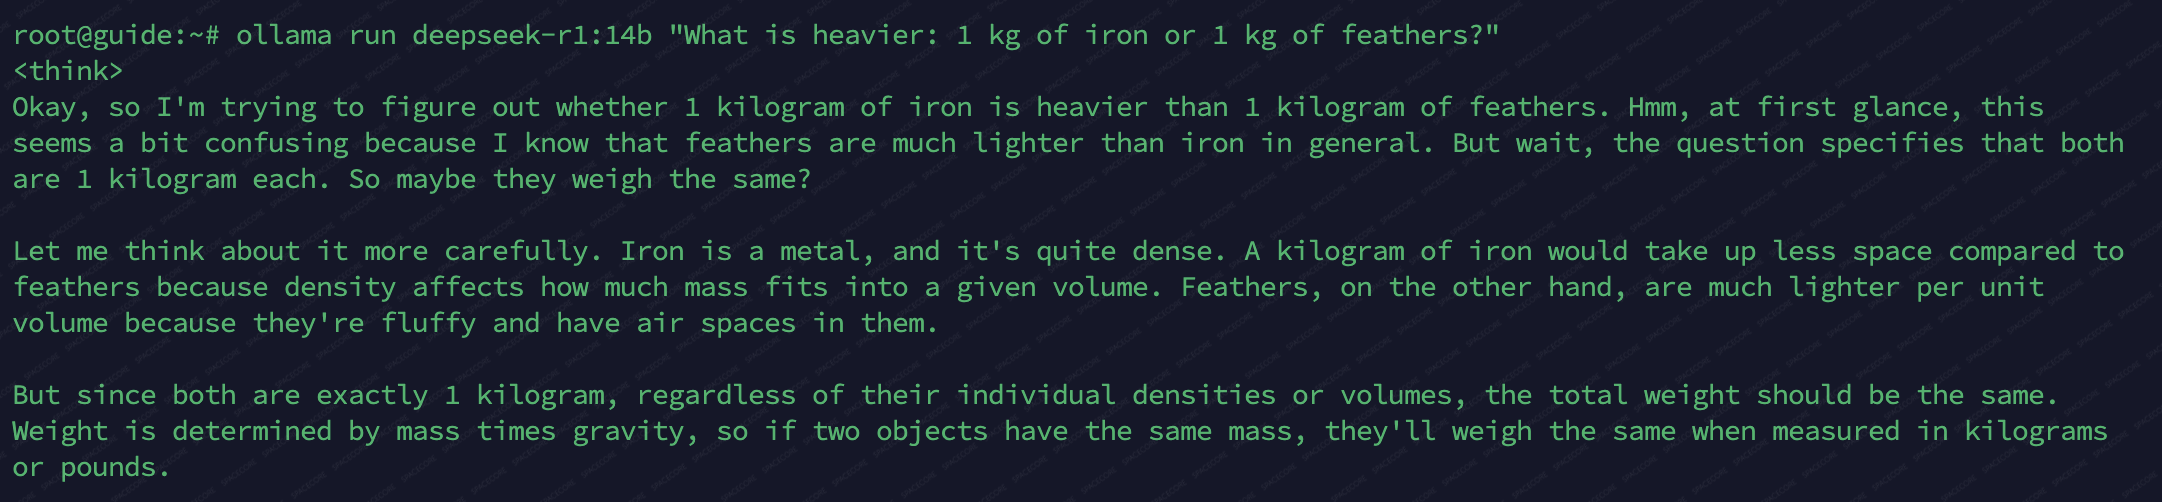
Después de instalarse, Ollama ya funciona como servicio, y su API está disponible en el propio servidor en la dirección http://127.0.0.1:11434. No hace falta ejecutar ollama serve a mano. Un ejemplo de petición a la API:
curl http://127.0.0.1:11434/api/generate -d '{"model": "deepseek-r1:14b", "prompt": "¡Hola!", "stream": false}'WARNING
La API de Ollama no tiene contraseña. No abras el puerto 11434 a internet – si necesitas acceder desde fuera, conéctate a través de un túnel SSH o protege la API con un servidor web con autenticación.
Para ver los modelos instalados:
ollama list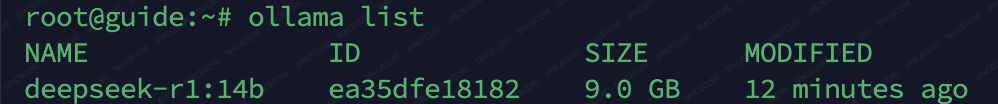
Recomendaciones para elegir servidor
Para que los modelos DeepSeek R1 funcionen de forma estable, te recomendamos servidores con suficiente memoria RAM (mejor con algo de margen) y discos NVMe rápidos. Necesitas más RAM de lo que pesa el modelo, porque a su tamaño hay que sumar 2–4 GB para el sistema y el contexto de la conversación.
Sin tarjeta gráfica, los modelos funcionan en el procesador. Las versiones 1.5B–8B responden rápido, la 14B bastante más despacio, y la 32B solo genera unas pocas palabras por segundo.
Nuestros recursos
Canal de Telegram: https://t.me/f3cloud_news
Web del hosting: https://f3cloud.com