
DeepSeek R1 es un modelo de lenguaje abierto que puedes ejecutar en tu propio servidor. Así tus conversaciones no salen del servidor, las respuestas no dependen de la carga de servidores ajenos y puedes usar el modelo sin límite de peticiones. Lo más cómodo es ejecutarlo con Ollama, un programa que descarga modelos y da acceso a ellos desde el terminal y por API. En este artículo veremos qué es exactamente lo que ejecutas, cuánta memoria hace falta y cómo no equivocarte al elegir el servidor, y después lo instalaremos todo paso a paso. Hemos probado los comandos y las mediciones de velocidad en nuestro servidor DE-RZ9-4 con Debian 12, y la versión de Ollama en el momento de la prueba era la 0.40.7.
Qué se ejecuta realmente en el servidor
El modelo completo DeepSeek R1 es enorme. Tiene 671 000 millones de parámetros y, aun comprimido, ocupa unos 404 GB, así que no cabe en un VPS normal. Lo que Ollama ofrece con los nombres deepseek-r1:1.5b, 7b, 14b y demás son modelos destilados. Se crearon así. El gran DeepSeek R1 resolvió una enorme cantidad de tareas, y unos modelos más pequeños, construidos sobre las bases abiertas Qwen y Llama, se entrenaron para repetir sus razonamientos. Como resultado adoptan la forma de razonar del modelo grande, pero siguen siendo decenas y cientos de veces más compactos. Por ejemplo, el modelo 8b está construido sobre Qwen3 8B y entrenado con la versión actualizada DeepSeek R1-0528.
Todos estos modelos son modelos de razonamiento. Antes de dar la respuesta, escriben su línea de pensamiento, y en el terminal este bloque empieza con la palabra Thinking.... Esto hace que las respuestas a preguntas difíciles sean más precisas, pero también más largas, porque el modelo tiene que generar más texto. Los pesos de DeepSeek R1 se distribuyen con la licencia MIT y sirven para proyectos comerciales, y a los modelos basados en Llama se les aplica además la licencia de Llama.
DeepSeek también tiene modelos más nuevos, como DeepSeek V3.1 y V4. Sin embargo, V3.1 solo existe en su tamaño completo de 671B, y V4 en Ollama solo está disponible como modelo en la nube, así que para ejecutar un modelo en tu propio servidor queda la serie R1.
Por qué el modelo necesita memoria y no una tarjeta gráfica
Un modelo de lenguaje es, ante todo, un enorme conjunto de números llamados pesos. Para generar cada palabra siguiente, o más exactamente un fragmento de palabra llamado token, el procesador tiene que recorrer todos los pesos del modelo. De aquí salen dos conclusiones importantes. Primero, el modelo entero debe caber por completo en la memoria RAM, porque si no, el sistema empezará a cargarlo desde el disco y la velocidad caerá en picado. Segundo, en un servidor sin tarjeta gráfica la velocidad de respuesta depende sobre todo de lo rápido que el procesador pueda leer los pesos de la memoria, así que un modelo más pequeño responde bastante más rápido que uno grande.
En Ollama, los modelos vienen comprimidos por defecto a unos cuatro o cinco bits por parámetro, y de ahí sus tamaños. Un modelo de 8000 millones de parámetros ocupa unos 5 GB, y uno de 14 000 millones, unos 9 GB. Pero hace falta más memoria de lo que pesa el archivo. El modelo necesita espacio para el contexto de la conversación, y el sistema y el propio Ollama también necesitan memoria. Por eso conviene elegir un servidor con un margen de unos cuantos gigabytes por encima del tamaño del modelo.
Lo que pasa sin ese margen lo hemos comprobado en la práctica. En un servidor de pruebas con 1 GB de memoria y un archivo de swap, el modelo más pequeño, 1.5b, de 1,1 GB, se descargó sin problemas, pero tras la pregunta «¿Cuánto es 17 por 23?» en 8 minutos solo llegó a mostrar Thinking... y una palabra. Toda la memoria y la mayor parte del swap estaban ocupados, y el servidor prácticamente se detuvo.
En el servidor DE-RZ9-4, con 4 núcleos y 8 GB de memoria, la situación es muy distinta. Hicimos la misma pregunta a los dos modelos y miramos la velocidad de generación que Ollama muestra con el parámetro --verbose. El modelo 8b ocupó 5,9 GB de memoria y escribía unos 5 tokens por segundo. Respondió correctamente «391», pero antes estuvo razonando mucho rato, y la respuesta completa tardó 1 minuto y 22 segundos. El modelo 1.5b fue más de cuatro veces más rápido, con unos 22 tokens por segundo, y también dio la respuesta correcta, en 34 segundos. Sin embargo, ignoró la petición de responder de forma breve, desarrolló tres maneras de multiplicar y metió palabras en inglés en su respuesta en ruso. Este ejemplo muestra bien lo que cuesta el tamaño. El modelo pequeño es más rápido, pero sigue las instrucciones bastante peor y mezcla idiomas con más frecuencia.
Qué modelo y qué servidor elegir
Los tamaños de los modelos son los del catálogo de Ollama, y los planes están elegidos para que haya memoria de sobra. Nuestros VPS no tienen tarjetas gráficas, y todos los modelos funcionan en el procesador.
| Modelo | Tamaño | Base | Plan |
|---|---|---|---|
deepseek-r1:1.5b | 1,1 GB | Qwen 2.5 | DE-RZ9-2, 2 vCPU y 4 GB |
deepseek-r1:7b | 4,7 GB | Qwen 2.5 | DE-RZ9-4, 4 vCPU y 8 GB |
deepseek-r1:8b | 5,2 GB | Qwen3, versión R1-0528 | DE-RZ9-4, 4 vCPU y 8 GB |
deepseek-r1:14b | 9 GB | Qwen 2.5 | DE-RZ9-8, 8 vCPU y 16 GB |
deepseek-r1:32b | 20 GB | Qwen 2.5 | DE-RZ9-16, 16 vCPU y 32 GB |
deepseek-r1:70b | 43 GB | Llama 3.3 | hace falta un servidor dedicado |
deepseek-r1:671b | 404 GB | modelo completo | hace falta un servidor dedicado |
Para una primera toma de contacto basta con 1.5b, pero en nuestra prueba en ruso se quedó algo corto. Una elección sensata para la mayoría de las tareas es el modelo 8b. Ollama lo descarga por defecto si no indicas el tamaño, y está entrenado con la versión más reciente, R1-0528. Los modelos 14b y 32b son más grandes y suelen resolver mejor las tareas complejas, pero en el procesador responden más despacio.
Si no sabes si te bastará el plan
Empieza con un plan más pequeño y el modelo 8b. Si la calidad de las respuestas te convence pero la velocidad no, puedes pasar a un plan superior, y los datos y la dirección IP del servidor se conservan. Más adelante no se puede bajar a un plan inferior, porque el disco del servidor no se puede reducir.
Qué necesitas
- Un servidor con Debian 12 o Ubuntu 24.04 y la memoria que indica la tabla de arriba. Si todavía no tienes servidor, contrátalo siguiendo la guía.
- Espacio libre en disco. El propio Ollama ocupa unos 2 GB, más el tamaño del modelo.
- Conexión por SSH, por ejemplo con Termius. Los comandos se ejecutan como
root.
Paso 1. Instala Ollama
Ollama se instala con el script oficial en un solo comando.
# Instalamos Ollama con el script oficial
curl -fsSL https://ollama.com/install.sh | sh
El script descargará el programa, le creará un usuario y un servicio propios y lo pondrá en marcha. Al final indicará que la API está disponible en 127.0.0.1:11434 y avisará de que no ha encontrado ninguna tarjeta gráfica. En un VPS es normal, los modelos funcionarán en el procesador.
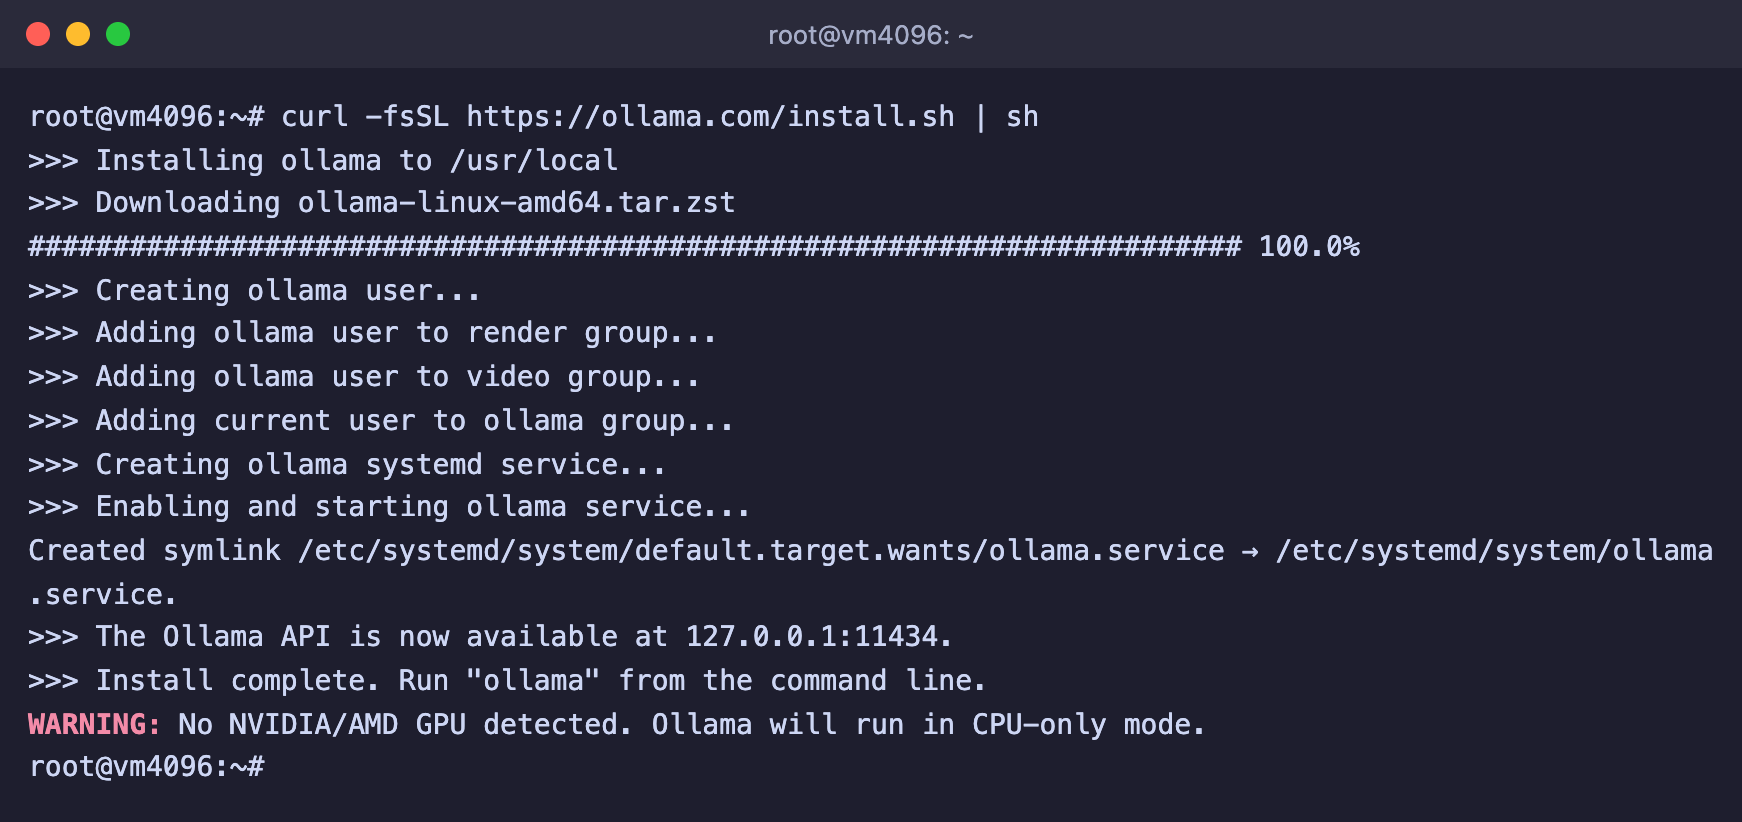
Ollama instalado
Paso 2. Descarga el modelo
Indica el modelo que hayas elegido en la tabla. Por ejemplo, para 8b el comando es este.
# Descargamos el modelo DeepSeek R1 8B
ollama pull deepseek-r1:8b
Ollama mostrará el progreso de la descarga y al final escribirá success. En nuestro servidor, el modelo 1.5b se descargó a unos 15 MB/s.
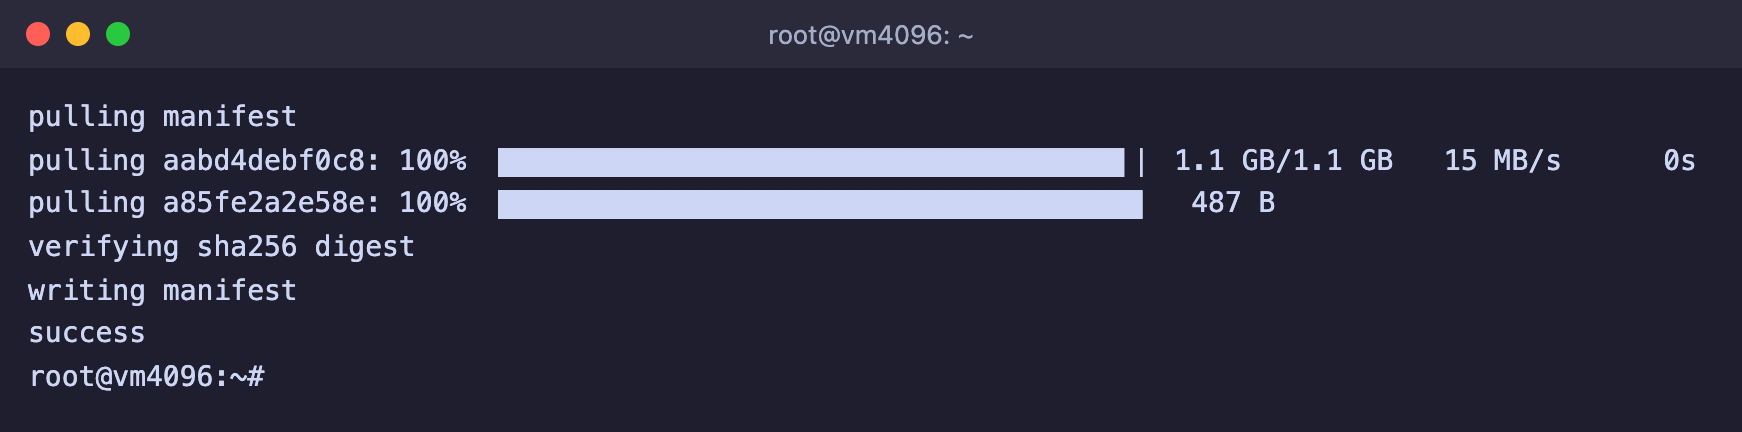
Modelo descargado
Paso 3. Haz una pregunta
Inicia el modelo en modo de diálogo.
ollama run deepseek-r1:8bAparecerá una línea para escribir. Escribe tu pregunta y pulsa Enter. Primero el modelo mostrará el bloque de razonamiento después de la palabra Thinking... y luego la respuesta en sí. Para salir del diálogo, escribe /bye.
Si añades el parámetro --verbose, después de la respuesta Ollama mostrará el tiempo y la velocidad. La línea principal aquí es eval rate, el número de tokens que el modelo genera por segundo.
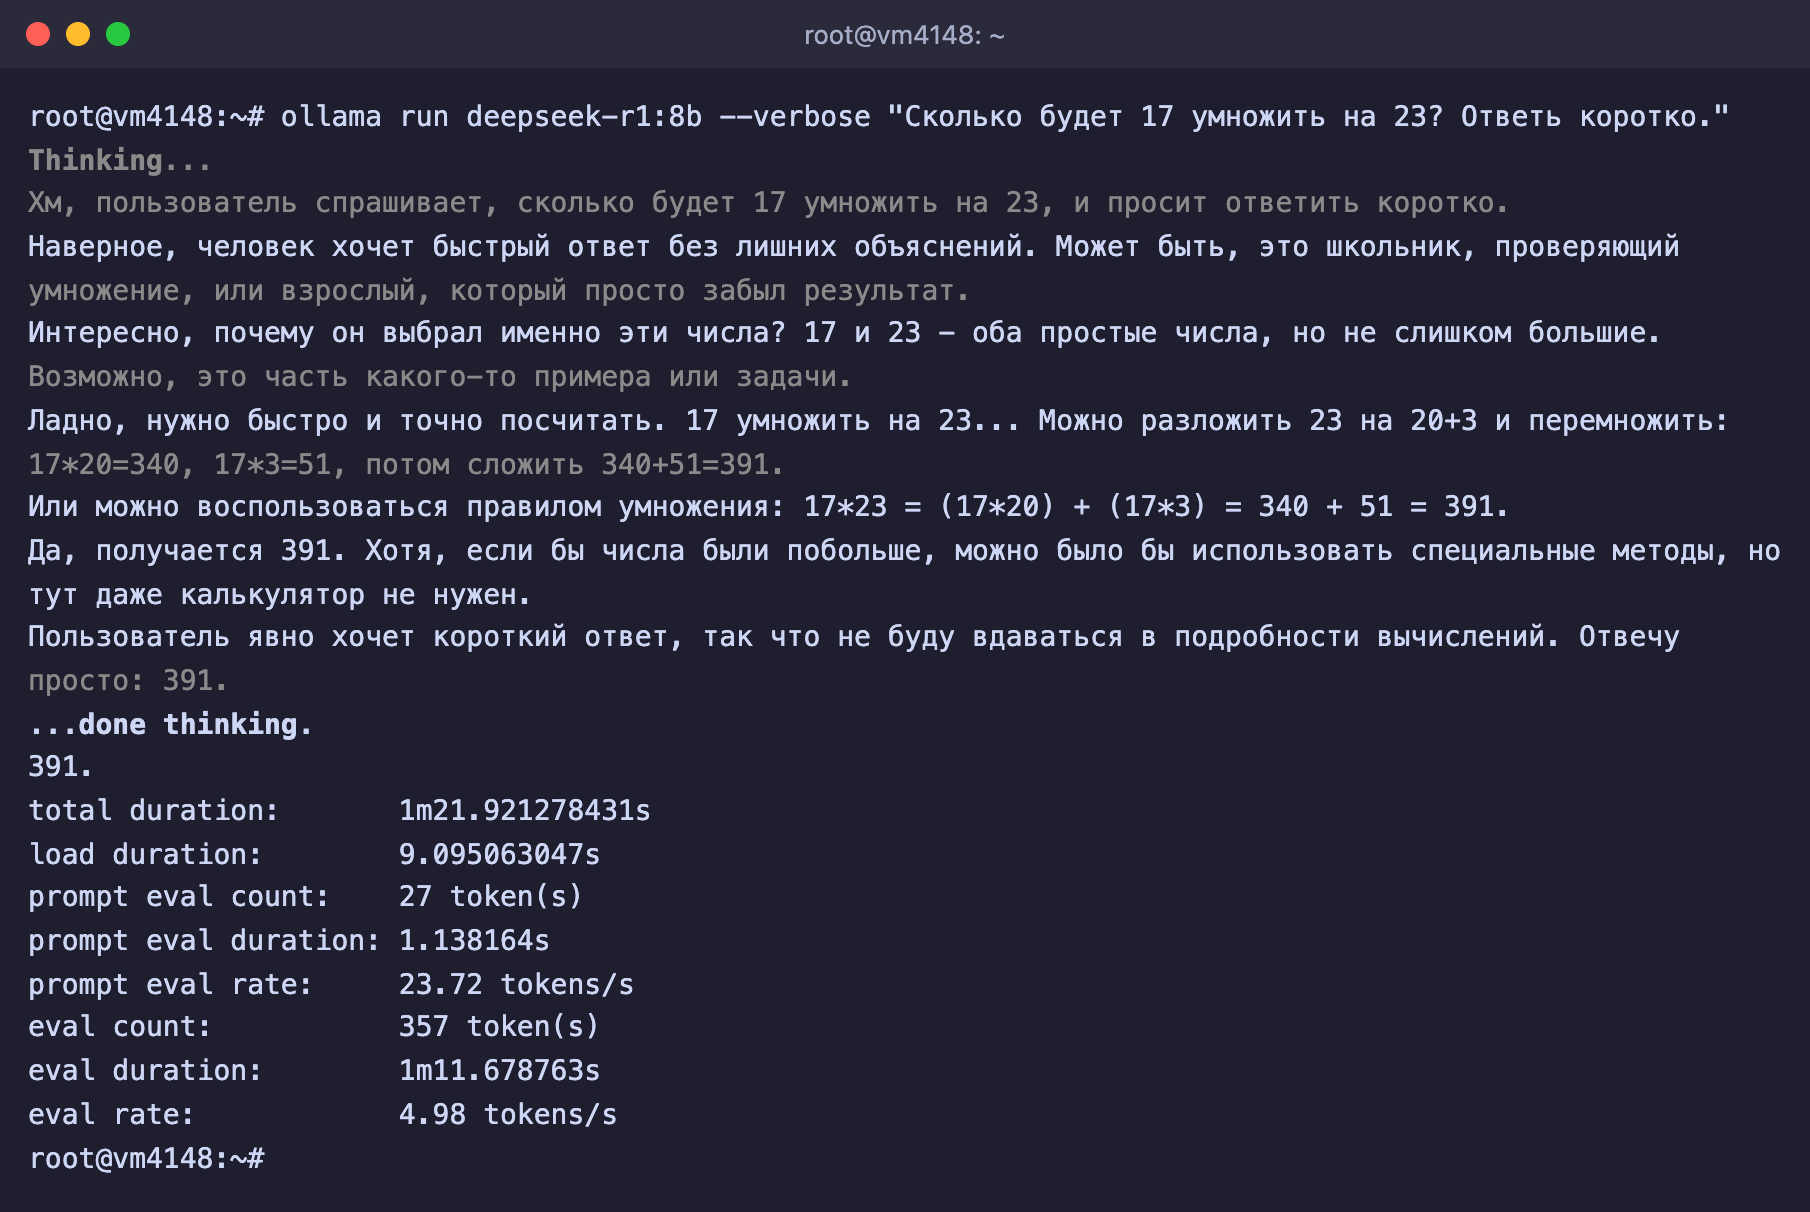
Respuesta del modelo 8b en DE-RZ9-4
También puedes hacer una sola pregunta directamente, sin diálogo. Es cómodo para scripts.
ollama run deepseek-r1:8b "Explica con palabras sencillas qué es DNS"Trabajo con la API
Después de la instalación, Ollama funciona como servicio y acepta peticiones por API en el propio servidor. No hace falta ejecutar ollama serve a mano. Así puedes conectar el modelo a tu bot, a tu web o al agente OpenClaw.
# Petición al modelo a través de la API de Ollama
curl http://127.0.0.1:11434/api/chat -d '{
  "model": "deepseek-r1:8b",
  "messages": [{"role": "user", "content": "¡Hola!"}],
  "stream": false
}'
Para acceder a la API desde tu ordenador sin abrirla a internet, usa un túnel SSH. Ejecuta el comando en tu ordenador y no cierres la ventana, y a partir de ese momento la API estará disponible en tu equipo en http://127.0.0.1:11434.
# Redirigimos el puerto de Ollama del servidor a tu ordenador
ssh -N -L 11434:127.0.0.1:11434 root@IP_DEL_SERVIDOR
No abras el puerto 11434 a internet
La API de Ollama no tiene contraseña. Cualquiera que llegue a ella podrá usar tu servidor, descargar modelos en él y ocupar toda la memoria.
Interfaz web Open WebUI
Chatear con el modelo en el terminal es incómodo, por eso a Ollama se le suele añadir una interfaz web. La opción más extendida es Open WebUI, un chat en el navegador como los que ya conoces, parecido a ChatGPT. Se conecta a Ollama en el mismo servidor y muestra los modelos que has descargado en él. Instalamos la imagen ligera slim. Pesa unos 200 MB en lugar de los 1,6 GB de la completa, porque no trae el procesamiento de documentos integrado ni las funciones de voz, y para un chat normal no hacen falta.
Si todavía no tienes Docker en el servidor, instálalo con el script oficial.
curl -fsSL https://get.docker.com | shInicia Open WebUI.
docker run -d --network=host \
  -e HOST=127.0.0.1 \
  -e OLLAMA_BASE_URL=http://127.0.0.1:11434 \
  -e WEBUI_SECRET_KEY=$(openssl rand -hex 32) \
  -v open-webui:/app/backend/data \
  --name open-webui --restart always \
  ghcr.io/open-webui/open-webui:slim
El parámetro HOST=127.0.0.1 hace que la interfaz solo esté disponible en el propio servidor, y OLLAMA_BASE_URL indica dónde funciona Ollama. En nuestro servidor de pruebas Open WebUI arrancó sin errores y ocupó unos 320 MB de memoria, así que suma esos cientos de megabytes a la memoria que necesita el modelo.
Abre la interfaz desde tu ordenador a través de un túnel SSH. Ejecuta el comando en tu ordenador y no cierres la ventana.
# Redirigimos el puerto de Open WebUI del servidor a tu ordenador
ssh -N -L 8080:127.0.0.1:8080 root@IP_DEL_SERVIDOR
Abre http://localhost:8080 en el navegador y pulsa Empezar (Давайте начнём). Se abrirá el formulario para crear la primera cuenta.
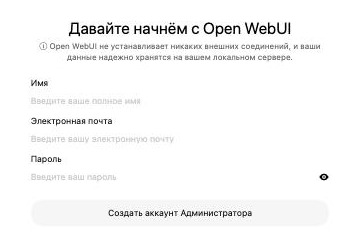
Primera cuenta en Open WebUI
La primera cuenta se convierte en administrador
Gestiona los usuarios y toda la configuración de Open WebUI. Créala nada más arrancar Open WebUI y ponle una contraseña segura.
Al entrar se abrirá el chat. Open WebUI encuentra por sí solo los modelos descargados en Ollama, y puedes elegir el que necesites directamente en el campo de entrada.
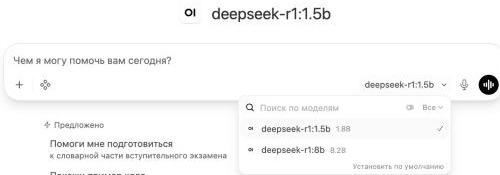
Elección del modelo en Open WebUI
Open WebUI pliega el razonamiento del modelo en una sola línea, que puedes desplegar con un clic, y debajo muestra la respuesta final.
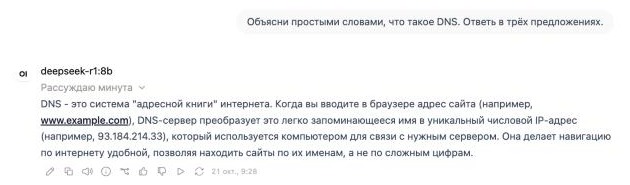
Respuesta de DeepSeek 8b en Open WebUI
El modelo necesita casi todo el servidor
En nuestro DE-RZ9-4 funcionaban a la vez otros programas, los 8 GB de memoria ya no bastaron, una parte pasó al swap y la respuesta en Open WebUI tardó más de dos minutos. Si instalas el modelo 8b, no pongas nada pesado en el mismo servidor.
Comandos útiles
# Modelos descargados
ollama ls

# Modelos cargados en memoria ahora mismo
ollama ps

# Sacar el modelo de la memoria
ollama stop deepseek-r1:8b

# Borrar el modelo del disco
ollama rm deepseek-r1:1.5b

# Estado del servicio Ollama
systemctl status ollama
Preguntas frecuentes
El modelo responde muy despacio
Comprueba si hay memoria suficiente con el comando free -h. Si el swap está ocupado (la línea Swap), el modelo no cabe en la memoria. Elige un modelo más pequeño o pasa a un plan superior. Si la memoria está bien, la respuesta solo será más rápida con un procesador más rápido y con más núcleos o con un modelo de menor tamaño.
El modelo razona durante mucho tiempo y genera un texto largo
Es una característica de los modelos de razonamiento. Pide en la pregunta que responda de forma breve. Si no necesitas el razonamiento, para tareas sencillas puedes usar un modelo normal sin el bloque Thinking....
Cómo desinstalar Ollama por completo
Borra los modelos con el comando ollama rm, después detén el servicio y elimina el programa.
systemctl disable --now ollama
rm -rf /usr/local/lib/ollama /usr/local/bin/ollama /usr/share/ollama
Nuestros recursos
Canal de Telegram: https://t.me/f3cloud_news
Web del hosting: https://f3cloud.com