> Полный список статей есть в [llms.txt](https://docs.f3cloud.com/llms.txt). Markdown-версия есть у каждой страницы, достаточно добавить .md к её адресу. Эта страница в Markdown: [https://docs.f3cloud.com/ru/ai/deepseek-installation.md](https://docs.f3cloud.com/ru/ai/deepseek-installation.md).
# Установка DeepSeek R1 на VPS через Ollama – выбор модели и сервера
Как установить DeepSeek R1 на VPS через Ollama без видеокарты. Чем отличаются модели 1.5b–671b, сколько памяти нужно каждой и какой тариф выбрать, установка Ollama, загрузка модели, работа через API, веб-интерфейс Open WebUI и SSH-туннель, частые ошибки.
**DeepSeek R1** – открытая языковая модель, которую можно запустить на собственном сервере. Тогда переписка никуда не уходит, ответы не зависят от загрузки чужих серверов, а пользоваться моделью можно без ограничений по числу запросов. Удобнее всего запускать её через **Ollama**, программу, которая скачивает модели и даёт к ним доступ из терминала и по API. В этой статье мы разберёмся, что именно вы запускаете, сколько для этого нужно памяти и как не ошибиться с сервером, а затем установим всё по шагам. Команды и замеры скорости мы проверили на нашем сервере **DE-RZ9-4** с Debian 12, версия Ollama на момент проверки **0.40.7**.
***
## Что на самом деле запускается на сервере
Полная модель DeepSeek R1 огромна. Она содержит 671 миллиард параметров и даже в сжатом виде занимает около **404 ГБ**, поэтому на обычном VPS она не поместится. То, что Ollama предлагает под именами `deepseek-r1:1.5b`, `7b`, `14b` и так далее, – это дистиллированные модели. Их создали так. Большая DeepSeek R1 решала множество задач, а модели поменьше, построенные на открытых основах Qwen и Llama, обучались повторять её рассуждения. В итоге они перенимают манеру большой модели, но остаются в десятки и сотни раз компактнее. Например, модель `8b` построена на Qwen3 8B и обучена на обновлённой версии DeepSeek R1-0528.
Все эти модели относятся к рассуждающим. Прежде чем дать ответ, они выписывают ход мысли, и в терминале этот блок начинается со слова `Thinking...`. Это делает ответы на сложные вопросы точнее, но удлиняет их, ведь модели нужно сгенерировать больше текста. Веса DeepSeek R1 распространяются по лицензии MIT и подходят для коммерческих проектов, а у моделей на основе Llama дополнительно действует лицензия Llama.
У DeepSeek есть и более новые модели, например DeepSeek V3.1 и V4. Однако V3.1 существует только в полном размере 671B, а V4 в Ollama доступна лишь как облачная модель, поэтому для запуска на своём сервере остаётся линейка R1.
***
## Почему модели нужна память, а не видеокарта
Языковая модель – это прежде всего огромный набор чисел, весов. Чтобы сгенерировать каждое следующее слово, а точнее фрагмент слова, называемый токеном, процессор должен пройти через все веса модели. Отсюда следуют два важных вывода. Во-первых, вся модель должна целиком помещаться в оперативную память, иначе система начнёт подкачивать её с диска и скорость упадёт многократно. Во-вторых, на сервере без видеокарты скорость ответа определяется прежде всего тем, как быстро процессор может прочитать веса из памяти, поэтому меньшая модель отвечает заметно быстрее большой.
Модели в Ollama по умолчанию сжаты примерно до четырёх-пяти бит на параметр, отсюда и их размеры. Модель на 8 миллиардов параметров занимает около 5 ГБ, на 14 миллиардов около 9 ГБ. Но памяти нужно больше, чем весит файл. Модели требуется место под контекст диалога, а системе и самой Ollama тоже нужна память. Поэтому сервер стоит выбирать с запасом в несколько гигабайт сверх размера модели.
Что бывает без такого запаса, мы проверили на практике. На тестовом сервере с 1 ГБ памяти и файлом подкачки самая маленькая модель `1.5b` весом 1,1 ГБ скачалась без проблем, но после вопроса «Сколько будет 17 умножить на 23?» за **8 минут** успела вывести только `Thinking...` и одно слово. Вся память и большая часть подкачки были заняты, и сервер практически остановился.
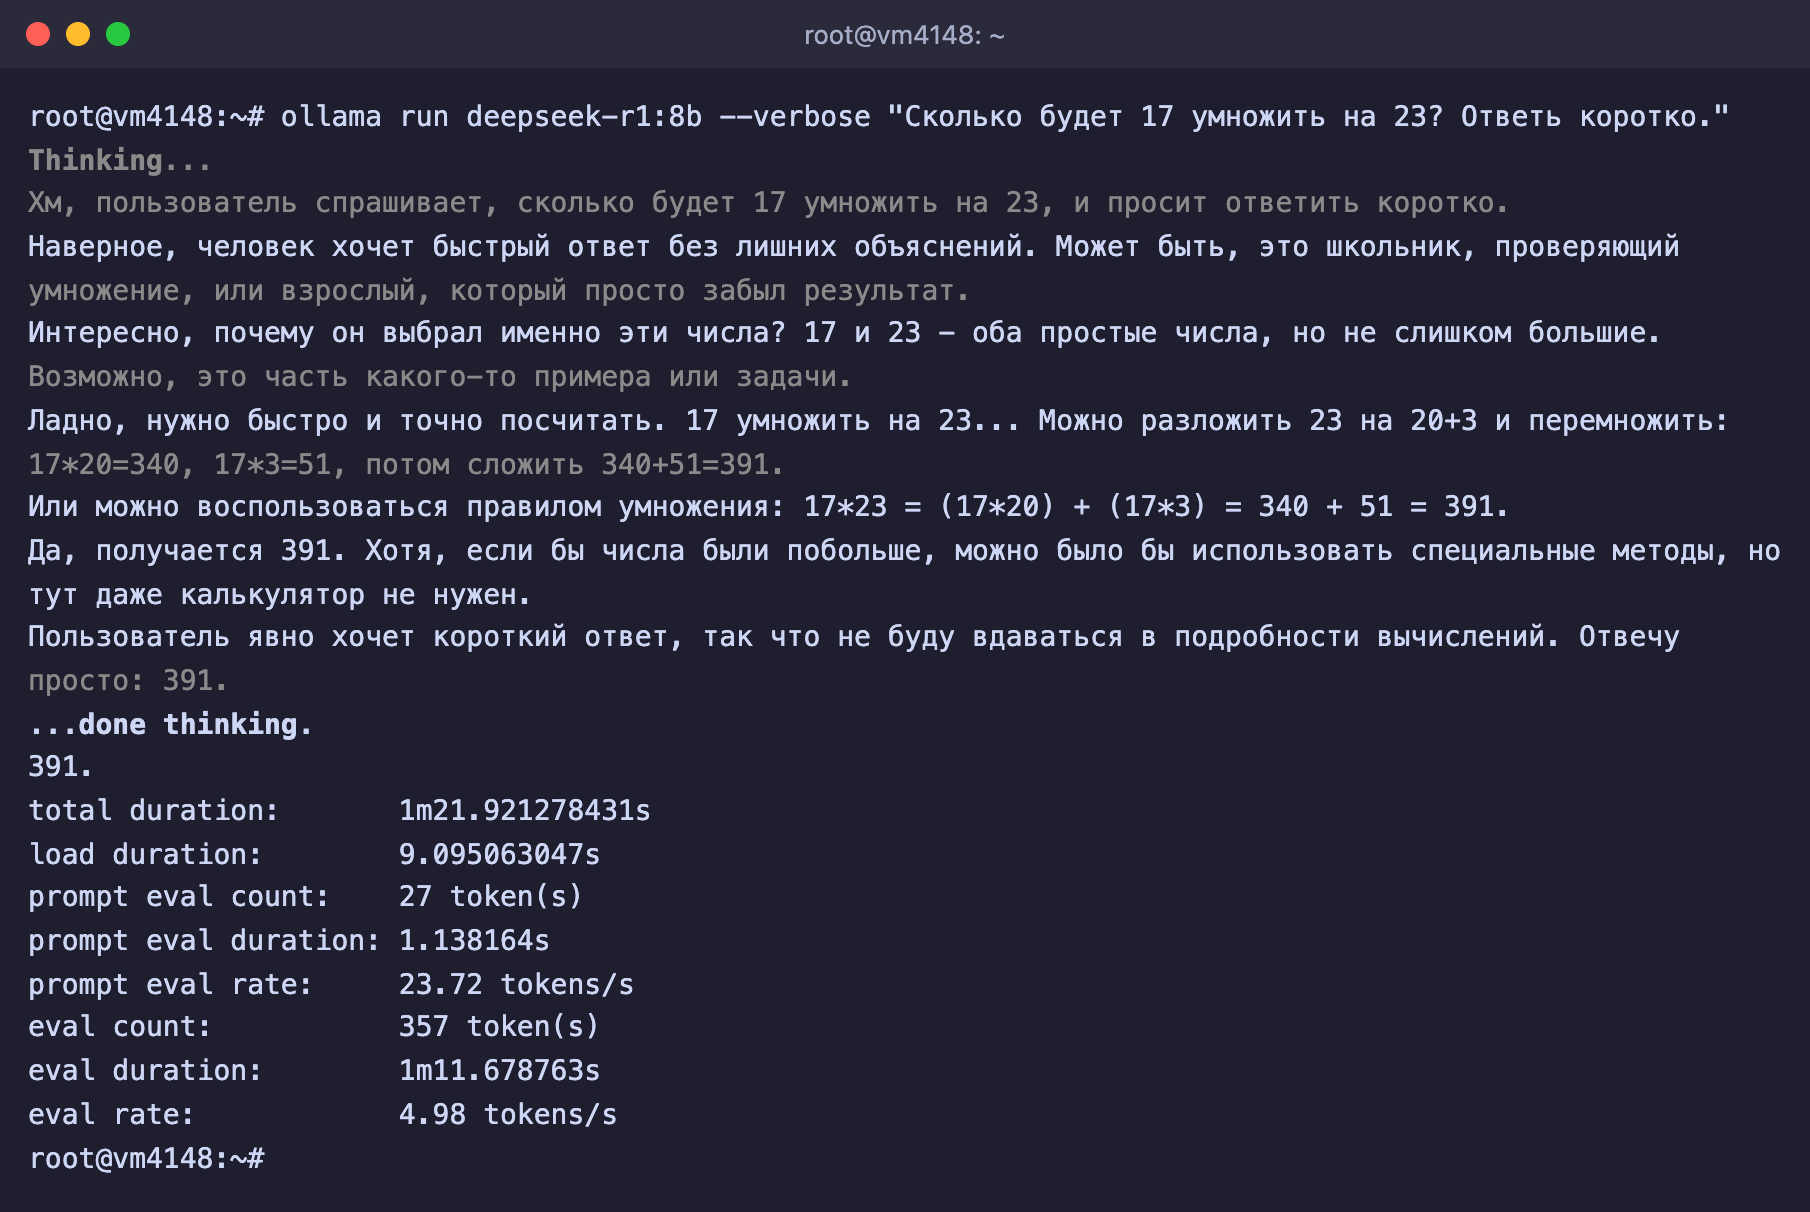
На сервере **DE-RZ9-4** с 4 ядрами и 8 ГБ памяти картина совсем другая. Мы задали обеим моделям тот же вопрос и посмотрели скорость генерации, которую Ollama показывает с ключом `--verbose`. Модель `8b` в памяти заняла **5,9 ГБ** и писала около **5 токенов в секунду**. Она правильно ответила «391», но перед этим долго рассуждала, и весь ответ занял **1 минуту 22 секунды**. Модель `1.5b` работала более чем вчетверо быстрее, около **22 токенов в секунду**, и тоже дала верный ответ за 34 секунды. Однако просьбу ответить коротко она проигнорировала, расписала три способа умножения и вставила в русский текст английские слова. Этот пример хорошо показывает цену размера. Меньшая модель быстрее, но заметно хуже следует инструкциям и чаще путает языки.
***
## Какую модель и сервер выбрать
Размеры моделей указаны по каталогу Ollama, тарифы подобраны так, чтобы памяти хватало с запасом. Видеокарт на наших VPS нет, все модели работают на процессоре.
| Модель | Размер | Основа | Тариф |
| --- | --- | --- | --- |
| `deepseek-r1:1.5b` | 1,1 ГБ | Qwen 2.5 | **DE-RZ9-2**, 2 vCPU и 4 ГБ |
| `deepseek-r1:7b` | 4,7 ГБ | Qwen 2.5 | **DE-RZ9-4**, 4 vCPU и 8 ГБ |
| `deepseek-r1:8b` | 5,2 ГБ | Qwen3, версия R1-0528 | **DE-RZ9-4**, 4 vCPU и 8 ГБ |
| `deepseek-r1:14b` | 9 ГБ | Qwen 2.5 | **DE-RZ9-8**, 8 vCPU и 16 ГБ |
| `deepseek-r1:32b` | 20 ГБ | Qwen 2.5 | **DE-RZ9-16**, 16 vCPU и 32 ГБ |
| `deepseek-r1:70b` | 43 ГБ | Llama 3.3 | нужен выделенный сервер |
| `deepseek-r1:671b` | 404 ГБ | полная модель | нужен выделенный сервер |
Для первого знакомства хватит `1.5b`, но для работы на русском языке она слабовата. Разумный выбор для большинства задач – модель `8b`. Её Ollama скачивает по умолчанию, если не указать размер, и она обучена на самой новой версии R1-0528. Модели `14b` и `32b` крупнее и обычно лучше справляются со сложными задачами, но на процессоре отвечают медленнее.
> **Не знаете, хватит ли тарифа.**
>
> Начните с меньшего тарифа и модели `8b`. Если ответы устраивают по качеству, но не по скорости, тариф можно повысить, данные и IP-адрес сервера при этом сохранятся. Понизить тариф потом нельзя, потому что диск сервера не уменьшается.
***
## Что понадобится
* **Сервер** с Debian 12 или Ubuntu 24.04 и объёмом памяти по таблице выше. Если сервера ещё нет, закажите его по [инструкции](https://docs.f3cloud.com/ru/client-area/order-vps.md).
* **Свободное место на диске**. Сама Ollama занимает около 2 ГБ, плюс размер модели.
* **Подключение по SSH**, например через [Termius](https://docs.f3cloud.com/ru/vps/termius-connection.md). Команды выполняются от имени `root`.
***
## Шаг 1. Установите Ollama
Ollama ставится официальным скриптом одной командой.
```bash
# Устанавливаем Ollama официальным скриптом
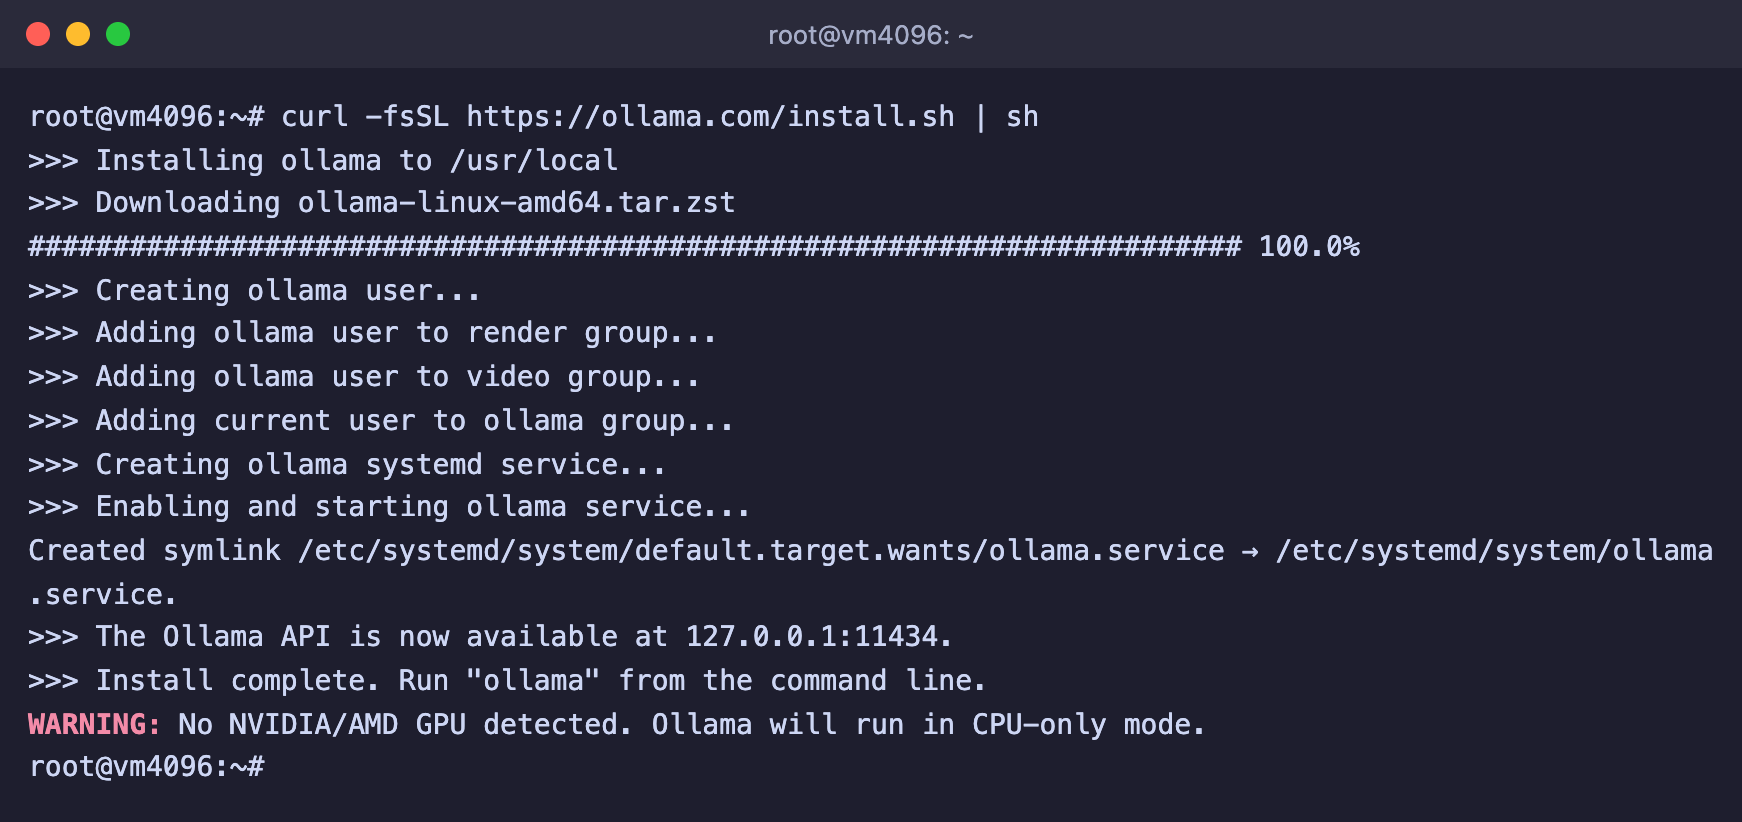
curl -fsSL https://ollama.com/install.sh | sh
```
Скрипт скачает программу, создаст для неё отдельного пользователя и службу и запустит её. В конце он сообщит, что API доступен по адресу `127.0.0.1:11434`, и предупредит, что видеокарта не найдена. На VPS это нормально, модели будут работать на процессоре.
Ollama установлена
***
## Шаг 2. Скачайте модель
Укажите модель, которую выбрали по таблице. Например, для `8b` команда будет такой.
```bash
# Скачиваем модель DeepSeek R1 8B
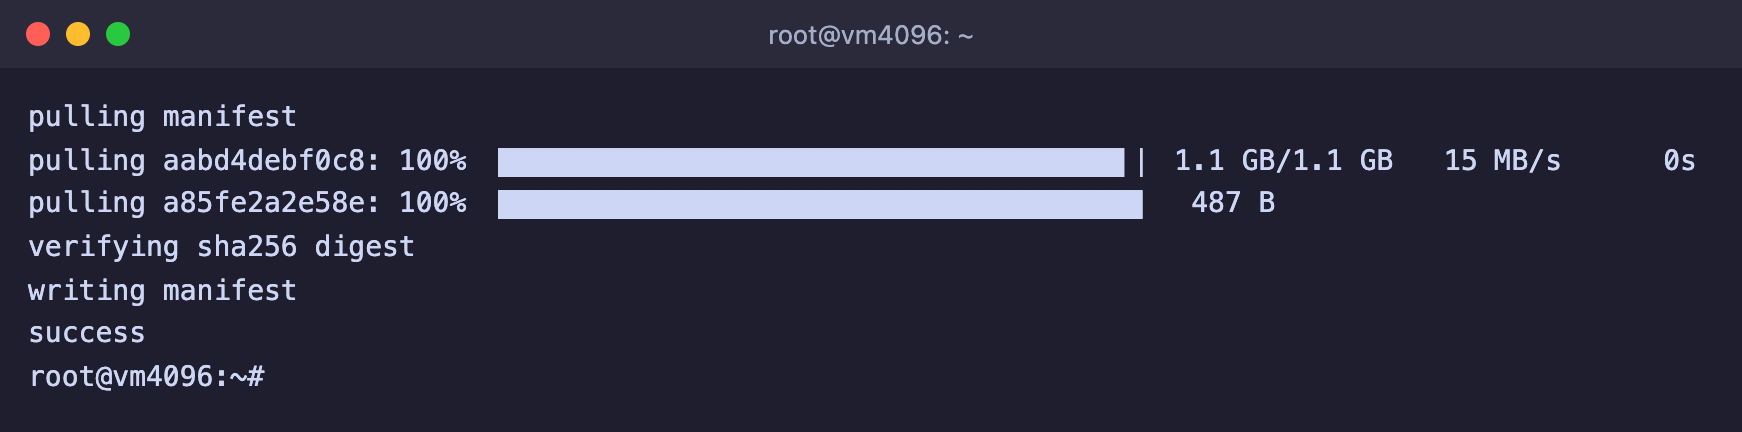
ollama pull deepseek-r1:8b
```
Ollama покажет ход загрузки и в конце напишет `success`. На нашем сервере модель `1.5b` скачивалась со скоростью около 15 МБ/с.
Модель загружена
***
## Шаг 3. Задайте вопрос
Запустите модель в режиме диалога.
```bash
ollama run deepseek-r1:8b
```
Появится строка ввода. Напишите вопрос и нажмите Enter. Сначала модель выведет блок рассуждений после слова `Thinking...`, затем сам ответ. Чтобы выйти из диалога, введите `/bye`.
Если добавить ключ `--verbose`, после ответа Ollama покажет время и скорость. Главная строка здесь **eval rate**, это число токенов, которые модель выдаёт в секунду.
Ответ модели 8b на DE-RZ9-4
Можно задать и один вопрос сразу, без диалога. Это удобно для скриптов.
```bash
ollama run deepseek-r1:8b "Объясни простыми словами, что такое DNS"
```
***
## Работа через API
После установки Ollama работает как служба и принимает запросы по API на самом сервере. Запускать `ollama serve` вручную не нужно. Так можно подключить модель к своему боту, сайту или к агенту [OpenClaw](https://docs.f3cloud.com/ru/ai/ustanovka-openclaw-clawdbot-na-vps.md).
```bash
# Запрос к модели через API Ollama
curl http://127.0.0.1:11434/api/chat -d '{
"model": "deepseek-r1:8b",
"messages": [{"role": "user", "content": "Привет!"}],
"stream": false
}'
```
Чтобы обращаться к API со своего компьютера, не открывая его в интернет, используйте SSH-туннель. Выполните команду на **своём компьютере** и не закрывайте окно, после этого API будет доступен у вас по адресу `http://127.0.0.1:11434`.
```bash
# Пробрасываем порт Ollama с сервера на свой компьютер
ssh -N -L 11434:127.0.0.1:11434 root@IP_сервера
```
> **Не открывайте порт 11434 в интернет.**
>
> У API Ollama нет пароля. Любой, кто до него доберётся, сможет пользоваться вашим сервером, скачивать на него модели и занимать всю память.
***
## Веб-интерфейс Open WebUI
Переписываться с моделью в терминале неудобно, поэтому к Ollama обычно добавляют веб-интерфейс. Самый распространённый вариант – **Open WebUI**, привычный чат в браузере, похожий на ChatGPT. Он подключается к Ollama на том же сервере и показывает скачанные в неё модели. Мы ставим облегчённый образ `slim`. Он весит около 200 МБ вместо 1,6 ГБ у полного, потому что в нём нет встроенной обработки документов и голосовых функций, а для обычного чата они не нужны.
Docker, если его ещё нет на сервере, установите официальным скриптом.
```bash
curl -fsSL https://get.docker.com | sh
```
Запустите Open WebUI.
```bash
docker run -d --network=host \
-e HOST=127.0.0.1 \
-e OLLAMA_BASE_URL=http://127.0.0.1:11434 \
-e WEBUI_SECRET_KEY=$(openssl rand -hex 32) \
-v open-webui:/app/backend/data \
--name open-webui --restart always \
ghcr.io/open-webui/open-webui:slim
```
Параметр `HOST=127.0.0.1` оставляет интерфейс доступным только на самом сервере, а `OLLAMA_BASE_URL` указывает, где работает Ollama. На нашем тестовом сервере Open WebUI запустился без ошибок и занял около **320 МБ** памяти, эти сотни мегабайт нужно прибавить к памяти для модели.
Откройте интерфейс со своего компьютера через SSH-туннель. Выполните команду на **своём компьютере** и не закрывайте окно.
```bash
# Пробрасываем порт Open WebUI с сервера на свой компьютер
ssh -N -L 8080:127.0.0.1:8080 root@IP_сервера
```
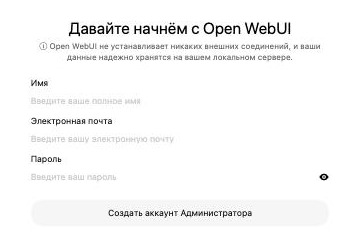
Откройте в браузере `http://localhost:8080` и нажмите Давайте начнём. Откроется форма создания первого аккаунта.
Первый аккаунт в Open WebUI
> **Первый аккаунт становится администратором.**
>
> Он управляет пользователями и всеми настройками Open WebUI. Создайте его сразу после запуска и придумайте надёжный пароль.
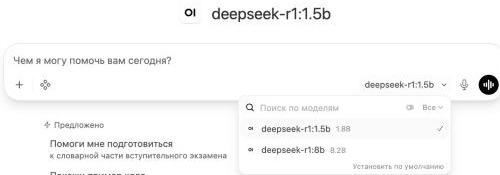
После входа откроется чат. Open WebUI сам находит модели, скачанные в Ollama, а нужную модель можно выбрать прямо в строке ввода.
Выбор модели в Open WebUI
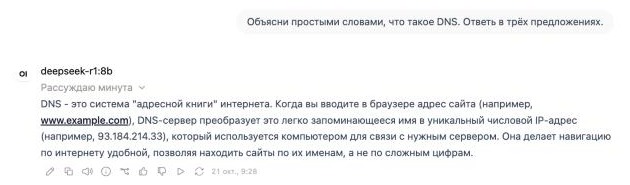
Рассуждения модели Open WebUI сворачивает в одну строку, её можно раскрыть нажатием, а ниже показывает готовый ответ.
Ответ DeepSeek 8b в Open WebUI
> **Модели нужен сервер почти целиком.**
>
> На нашем DE-RZ9-4 параллельно работали и другие программы, памяти 8 ГБ уже не хватило, часть ушла в подкачку, и ответ в Open WebUI занял больше двух минут. Если ставите модель `8b`, не размещайте на этом же сервере ничего тяжёлого.
***
## Полезные команды
```bash
# Скачанные модели
ollama ls
# Модели, загруженные в память сейчас
ollama ps
# Выгрузить модель из памяти
ollama stop deepseek-r1:8b
# Удалить модель с диска
ollama rm deepseek-r1:1.5b
# Состояние службы Ollama
systemctl status ollama
```
***
## Частые вопросы
Модель отвечает очень медленно
Проверьте, хватает ли памяти, командой `free -h`. Если занята подкачка (строка **Swap**), модель не помещается в память. Возьмите модель поменьше или повысьте тариф. Если память в порядке, ускорить ответ поможет только более быстрый процессор с большим числом ядер или модель меньшего размера.
Модель рассуждает очень долго и выдаёт длинный текст
Это особенность рассуждающих моделей. Попросите в вопросе отвечать кратко. Если рассуждения не нужны, для простых задач можно взять обычную модель без блока `Thinking...`.
Как удалить Ollama полностью
Удалите модели командой `ollama rm`, затем остановите службу и удалите программу.
```bash
systemctl disable --now ollama
rm -rf /usr/local/lib/ollama /usr/local/bin/ollama /usr/share/ollama
```
***
## Наши ресурсы
**Telegram-канал:** [https://t.me/f3cloud_news](https://t.me/f3cloud_news)\
**Сайт хостинга:** [https://f3cloud.com](https://f3cloud.com/ru)