> Die vollständige Liste der Artikel steht in [llms.txt](https://docs.f3cloud.com/llms.txt). Jede Seite gibt es auch als Markdown, dazu einfach .md an die Adresse anhängen. Diese Seite als Markdown: [https://docs.f3cloud.com/de/ai-solutions/deepseek-installation.md](https://docs.f3cloud.com/de/ai-solutions/deepseek-installation.md).

# DeepSeek R1 mit Ollama auf einem VPS installieren

So installieren Sie DeepSeek R1 mit Ollama auf einem VPS. Modellauswahl nach Arbeitsspeicher, Schritt-für-Schritt-Installation der Version 14B unter Ubuntu 22.04 und nützliche Befehle für die Arbeit.

DeepSeek AI ist ein fortschrittliches offenes KI-Modell, das seine Aufgaben auch ohne GPU hervorragend bewältigt. Zusammen mit Ollama lässt sich die KI lokal betreiben, sodass Sie Leistung und Datenschutz vollständig selbst in der Hand haben.

Wenn DeepSeek auf Ihrem eigenen Server läuft, ist die Sicherheit hoch, weil das Risiko entfällt, dass Daten über die API abgefangen werden. Da die offiziellen DeepSeek-Server häufig überlastet sind, nutzen Sie mit einer lokalen Installation ausschließlich Ihre eigenen Rechenressourcen und teilen sie mit niemandem.

***

### Welche Ressourcen brauchen wir?

Sehen wir uns die Modelle mit ihren unterschiedlichen Systemanforderungen im Vergleich an. Alle Modelle sind sowohl für den Betrieb auf der CPU als auch auf der GPU ausgelegt. Da die Installation jedoch auf einem Server erfolgt, liegt der Schwerpunkt dieses Artikels auf der Einrichtung und dem Betrieb des Modells mit der Rechenleistung des Prozessors.

<table><thead><tr><th>Modellversion</th><th>Größe</th><th>RAM</th><th>Passender Tarif</th><th></th></tr></thead><tbody><tr><td>deepseek-r1:1.5b</td><td>1.1 GB</td><td>ab 4 GB</td><td><a href="https://f3cloud.com/de">DE-RZ9-2</a></td><td>Einfache Aufgaben, ideal für Tests und erste Versuche.</td></tr><tr><td>deepseek-r1:7b</td><td>4.7 GB</td><td>ab 8 GB</td><td><a href="https://f3cloud.com/de">DE-RZ9-4</a></td><td>Texte schreiben und übersetzen. Einfachen Code entwickeln.</td></tr><tr><td>deepseek-r1:8b</td><td>5.2 GB</td><td>ab 8 GB</td><td><a href="https://f3cloud.com/de">DE-RZ9-4</a></td><td>Aktualisierte Version, die Ollama standardmäßig installiert, wenn Sie keine Modellgröße angeben.</td></tr><tr><td>deepseek-r1:14b</td><td>9 GB</td><td>ab 16 GB</td><td><a href="https://f3cloud.com/de">DE-RZ9-8</a></td><td>Erweiterte Möglichkeiten bei Entwicklung und Copywriting. Ein sehr gutes Gleichgewicht aus Geschwindigkeit und Funktionsumfang.</td></tr><tr><td>deepseek-r1:32b</td><td>20 GB</td><td>ab 32 GB</td><td><a href="https://f3cloud.com/de">DE-RZ9-16</a></td><td>Laut Tests der Entwickler mit OpenAI o1-mini vergleichbar. Vertiefte Datenanalyse. Antwortet auf dem Prozessor langsam.</td></tr><tr><td>deepseek-r1:70b</td><td>43 GB</td><td>ab 64 GB</td><td><a href="https://f3cloud.com/de/dedicated">Dedizierter Server (bald verfügbar)</a></td><td>Anspruchsvolle Berechnungen für Geschäftsaufgaben. Tiefgehende Datenanalyse und komplexe Entwicklung.</td></tr><tr><td>deepseek-r1:671b</td><td>404 GB</td><td>ab 512 GB</td><td><a href="https://f3cloud.com/de/dedicated">Individuelle Konfiguration (bald verfügbar)</a></td><td>Das vollständige Modell DeepSeek R1, das leistungsstärkste der Reihe. Es braucht einen leistungsstarken dedizierten Server mit NVMe-Laufwerken.</td></tr></tbody></table>

***

### DeepSeek 14B Schritt für Schritt auf dem Server installieren

Als Beispiel installieren wir das Modell 14B, das ein optimales Verhältnis von Leistung und Ressourcenverbrauch bietet. Die Anleitung gilt für jedes Modell aus der Liste, sodass Sie bei Bedarf auch eine andere Version installieren können.

> **Achtung.**
>
> Für die Installation verwenden wir den Tarif **DE-RZ9-16** (16 vCPU, 32 GB RAM) mit dem Betriebssystem Ubuntu 22.04 – seine Ressourcen reichen für das Modell 14B mehr als aus.

Aktualisieren Sie die Paketquellen und Pakete des Systems:

```bash
sudo apt update && sudo apt upgrade -y
```

Installieren Sie Ollama, den Manager, mit dem DeepSeek bereitgestellt wird:

```bash
curl -fsSL https://ollama.com/install.sh | sh && sudo systemctl start ollama
```

Laden Sie das gewählte DeepSeek-Modell herunter:

```bash
ollama pull deepseek-r1:14b
```

> **Hinweis.**
>
> Sie können `deepseek-r1:14b` durch eine andere Version aus der Tabelle ersetzen, zum Beispiel `deepseek-r1:32b`. Das Modell 14B ist etwa 9 GB groß und ist über eine Anbindung mit 1 Gbit/s in wenigen Minuten heruntergeladen.

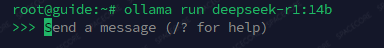
Starten Sie das DeepSeek-Modell:

```bash
ollama run deepseek-r1:14b
```

Nach diesem Befehl erscheint eine Eingabezeile für Nachrichten, und Sie können den Dialog mit der künstlichen Intelligenz beginnen.

<figure><img src="https://docs.f3cloud.com/img/image%20(25).png" alt=""><figcaption></figcaption></figure>

***

### Weitere Befehle

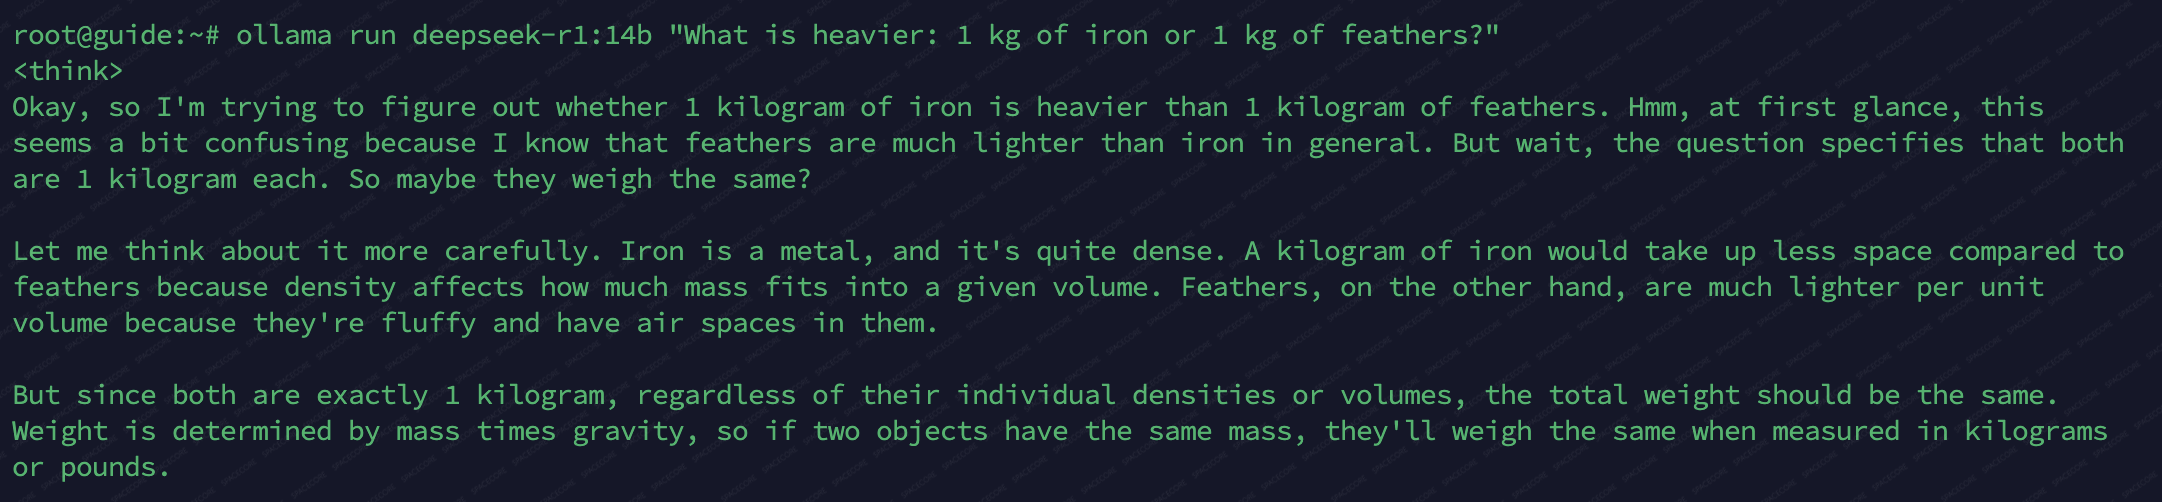
Sie können auch eine einzelne Anfrage senden:

```bash
ollama run deepseek-r1:14b "What is heavier: 1 kg of iron or 1 kg of feathers?"
```

<figure><img src="https://docs.f3cloud.com/img/image%20(26).png" alt=""><figcaption></figcaption></figure>

Nach der Installation läuft Ollama sofort als Dienst, und seine API ist auf dem Server selbst unter `http://127.0.0.1:11434` erreichbar. Sie müssen `ollama serve` nicht von Hand starten. Ein Beispiel für eine Anfrage an die API:

```bash
curl http://127.0.0.1:11434/api/generate -d '{"model": "deepseek-r1:14b", "prompt": "Hallo!", "stream": false}'
```

> **Achtung.**
>
> Die API von Ollama hat kein Passwort. Öffnen Sie Port 11434 nicht ins Internet – wenn Sie von außen zugreifen müssen, verbinden Sie sich über einen SSH-Tunnel oder schützen Sie die API mit einem Webserver mit Authentifizierung.

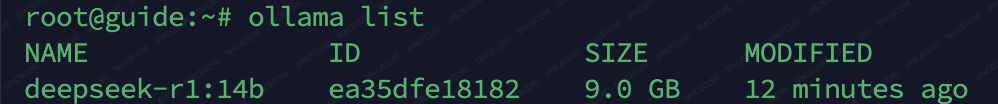
So prüfen Sie, welche Modelle installiert sind:

```bash
ollama list
```

<figure><img src="https://docs.f3cloud.com/img/image%20(27).png" alt=""><figcaption></figcaption></figure>

***

### Empfehlungen zur Serverwahl

Für einen stabilen Betrieb der Modelle DeepSeek R1 empfehlen wir Server mit ausreichend Arbeitsspeicher (am besten mit etwas Reserve) und schnellen NVMe-Laufwerken. Der Arbeitsspeicher muss größer sein als das Modell selbst, denn zu seiner Größe kommen 2–4 GB für das System und den Gesprächskontext hinzu.

Ohne Grafikkarte laufen die Modelle auf dem Prozessor. Die Versionen 1.5B–8B antworten schnell, 14B deutlich langsamer, und 32B schafft nur wenige Wörter pro Sekunde.

***

### Unsere Ressourcen

**Telegram-Kanal:** [https://t.me/f3cloud_news](https://t.me/f3cloud_news)
\
**Hosting-Website:** [https://f3cloud.com](https://f3cloud.com/de)